Context engineering en entreprise : que garder dans la fenêtre de contexte ?
Ajouter des tokens ne suffit pas. Le context engineering consiste à choisir le bon contexte au bon moment et à prouver son effet sur l'agent.
Réponse en bref
Le context engineering désigne la sélection et la maintenance de tout ce qui entre dans une inférence : instructions, historique, outils, résultats de recherche, mémoire et métadonnées. L'enjeu n'est pas de remplir la fenêtre avec un maximum de texte, mais de fournir les éléments pertinents, récents, autorisés et compréhensibles au moment où l'agent agit.
Pour une entreprise, la méthode consiste à cartographier les sources, définir une politique de priorité, filtrer les éléments inutiles, mesurer les réponses et conserver une trace du contexte réellement utilisé. Pour certaines équipes, un contexte court et stable suffit. Pour d'autres, un agent multi-étapes exige un contexte adaptatif avec résumés, limites d'outils et contrôle de provenance.
Du prompt au contexte complet
Anthropic décrit le context engineering comme l'évolution naturelle du prompt engineering : le système doit gérer l'ensemble des tokens disponibles, pas seulement le message d'instruction (Effective context engineering). Sa documentation recommande des instructions explicites, des exemples structurés et des balises XML pour séparer consignes, données et sorties (Prompting best practices).
Le contexte inclut aussi les outils et les résultats qu'ils renvoient. Une description trop longue, un historique périmé ou un document non filtré peuvent noyer la consigne importante. La question de conception devient donc : quelle information permet à l'agent de prendre la prochaine décision, et quelle information doit rester hors de portée ?
Le flux de sélection
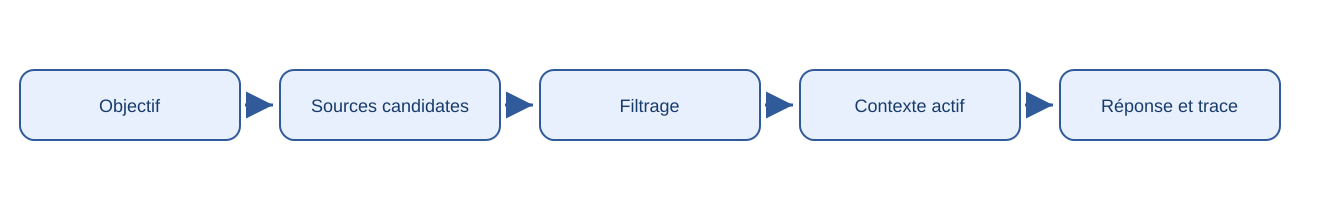
Schéma Nexxom : partir d'un objectif, filtrer les sources et conserver la preuve du contexte actif.
- Définir l'objectif. Décrivez la décision attendue et les erreurs acceptables.
- Lister les sources candidates. Instructions, profil, mémoire, documents, outils et résultats précédents.
- Filtrer. Appliquez droits d'accès, fraîcheur, pertinence, taille et redondance.
- Structurer. Séparez règles, données, exemples, incertitudes et actions autorisées.
- Limiter. Réservez une marge pour la sortie et les appels d'outils.
- Tracer. Enregistrez identifiants, versions, scores de sélection et éléments retirés.
- Évaluer. Comparez qualité, latence, coût, sécurité et taux d'escalade.
| Élément | Question | Contrôle |
|---|---|---|
| Instructions | La règle est-elle prioritaire et non contradictoire ? | Version et test de conflit |
| Historique | Est-il encore utile à la tâche ? | Fenêtre temporelle et résumé |
| Documents | La source est-elle autorisée et à jour ? | ACL, date et provenance |
| Outils | L'agent en a-t-il besoin maintenant ? | Permissions minimales |
| Mémoire | Peut-elle être corrigée ou oubliée ? | TTL, suppression et audit |
Pertinence avant quantité
Un contexte volumineux peut contenir plus d'informations, mais aussi plus de contradictions. Testez une stratégie par ajouts successifs : instruction seule, instruction plus contexte métier, puis contexte filtré. Mesurez la réussite sur un jeu stable et observez les erreurs introduites par les documents non pertinents.
| Stratégie | Avantage | Risque |
|---|---|---|
| Contexte brut | Mise en œuvre rapide | Bruit et conflits |
| Contexte filtré | Meilleure pertinence | Coût du classement |
| Contexte résumé | Historique compact | Perte de nuance |
| Contexte adaptatif | Ajusté à l'étape | Complexité et dérive |
Les valeurs de la matrice Plotly ci-dessous sont des heuristiques Nexxom, pas des scores de modèles.
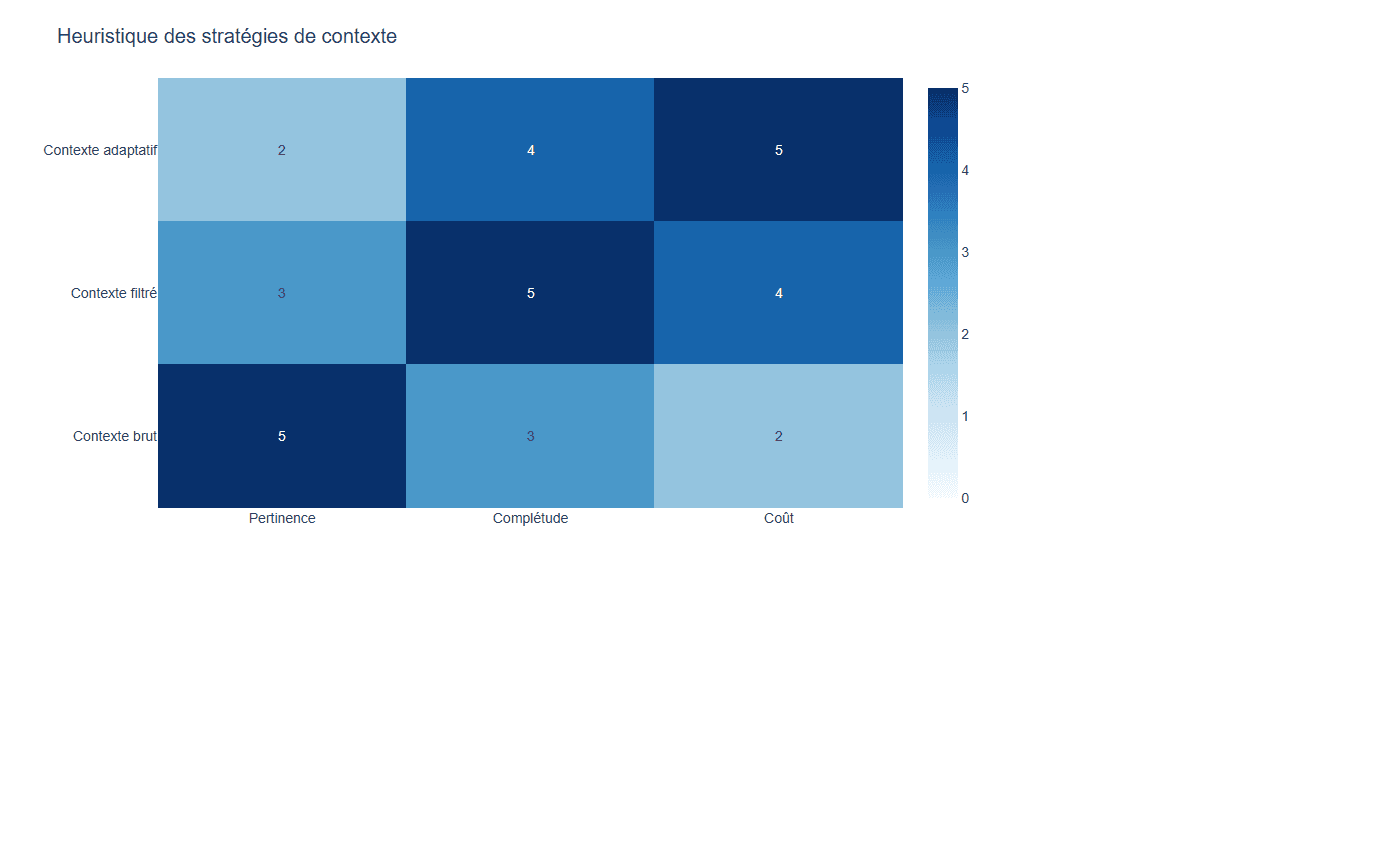
Matrice Plotly Nexxom : heuristique de 0 à 5 pour structurer une revue, pas un benchmark.
Gérer l'historique et la mémoire
Dans un agent multi-étapes, l'historique augmente vite. Conservez les décisions utiles, les résultats vérifiés et les contraintes encore actives. Résumez les échanges qui ne servent plus directement, en gardant un lien vers la trace originale. Une mémoire persistante doit avoir une durée de vie, un propriétaire et une capacité de correction.
Anthropic conseille de placer les longs documents au début et la question à la fin dans certains scénarios de contexte long, tout en structurant les documents avec des balises. Ce conseil doit être vérifié sur votre modèle, votre langue et votre tâche, pas appliqué comme une loi universelle.
Provenance, confidentialité et injection
Tout élément du contexte doit avoir une provenance. Distinguez instructions de confiance, données utilisateur, résultats de recherche et contenu récupéré. Un document peut contenir une instruction malveillante qui tente de prendre la priorité. L'article Nexxom sur la prompt injection décrit les contrôles à appliquer lorsque des agents lisent des sources externes.
| Risque | Exemple | Réponse |
|---|---|---|
| Injection | Document demandant d'ignorer la politique | Marquer le contenu comme données |
| Fuite | Mémoire d'un autre client | ACL et séparation de tenant |
| Obsolescence | Règle remplacée mais encore injectée | Date d'expiration |
| Contradiction | Deux procédures incompatibles | Priorité explicite et escalade |
| Sur-collecte | Données personnelles inutiles | Minimisation et redaction |
Le NIST AI RMF recommande d'identifier le contexte, les risques et les responsabilités sur tout le cycle de vie. Le Measure Playbook demande de conserver historiques, erreurs, plaintes et actions de supervision.
Mesurer l'effet réel
Ne mesurez pas uniquement le nombre de tokens. Suivez la réussite de la tâche, les citations correctes, la fréquence d'escalade, la latence, le coût et les refus de sécurité. Comparez la distribution des résultats lorsque le contexte change. Une amélioration moyenne peut masquer une régression sur un segment important.
Pour un système RAG, séparez récupération et génération. Pour un agent, ajoutez les appels d'outils et la trace des décisions. Notre article sur les traces d'agents montre pourquoi le résultat final ne suffit pas.
Versionner comme du logiciel
Un contexte de production doit avoir un identifiant de version. Versionnez instructions, exemples, règles de sélection, schémas d'outils, résumés et sources. Reliez chaque déploiement à un jeu de tests et à un rapport de régression. OpenAI recommande de relier les prompts à des évaluations et de les rejouer après chaque publication (Prompt management).
| Changement | Test nécessaire | Décision possible |
|---|---|---|
| Nouvelle règle | Cas positifs et négatifs | Publier ou revenir |
| Nouveau document | ACL, fraîcheur et citations | Ajouter avec suivi |
| Nouveau modèle | Comparaison par segment | Router ou bloquer |
| Nouveau outil | Permission et sortie d'erreur | Limiter les actions |
| Nouveau résumé | Perte d'information critique | Modifier ou abandonner |
Préparer la mise en production
Pour certaines équipes, un contexte statique et une revue mensuelle sont suffisants. Pour d'autres, l'agent doit recalculer ses sources à chaque étape et déclencher une revue dès qu'une donnée critique manque. Dans les deux cas, fixez un seuil de confiance opérationnel, une voie d'escalade et un propriétaire.
Checklist
- L'objectif et la prochaine décision sont-ils explicites ?
- Les sources ont-elles une provenance, une ACL et une date ?
- Les instructions sont-elles séparées des données récupérées ?
- L'historique est-il résumé sans perdre les décisions critiques ?
- Les outils sont-ils limités à l'étape courante ?
- Le contexte est-il versionné et relié à des évaluations ?
- Les coûts, latences, erreurs et escalades sont-ils suivis ?
- Une personne peut-elle retirer une source ou arrêter l'agent ?
Le context engineering transforme une fenêtre de tokens en système de décision gouverné. La bonne question n'est pas « comment ajouter davantage de contexte ? », mais « quelles preuves l'agent doit-il avoir maintenant, avec quelles limites ? ». Pour compléter cette approche, consultez notre méthode sur les sorties structurées et notre article RAG hybride.
Éviter les contextes contradictoires
La sélection doit définir une priorité lorsque plusieurs sources parlent du même sujet. Une règle de sécurité doit primer sur une préférence de style, et une politique à jour doit remplacer une copie ancienne. Attribuez à chaque source un propriétaire, une date de validité et un niveau de confiance. Si deux éléments restent incompatibles, l'agent doit demander une clarification ou transférer la décision.
Le contexte actif devrait être inspectable sans exposer les données sensibles. Conservez des identifiants et des empreintes plutôt que des copies complètes lorsque cela suffit à l'audit. Les équipes d'exploitation doivent pouvoir savoir quelle version de procédure a été injectée, pourquoi elle a été choisie et quels éléments ont été écartés. Cette visibilité réduit les diagnostics à l'aveugle.
Relier le contexte aux coûts
Un filtre supplémentaire ajoute parfois une latence, mais un contexte inutile augmente le coût de chaque appel et peut provoquer des reprises. Mesurez le coût par tâche réussie, pas seulement le prix par requête. Comparez un contexte court avec une reprise humaine, puis un contexte plus riche avec moins d'escalades. Le bon compromis dépend de la criticité, du volume et de la valeur du résultat.
Enfin, testez le comportement lorsque la fenêtre est presque pleine. L'agent doit savoir résumer, supprimer une information non critique ou demander une étape intermédiaire. Il ne doit pas tronquer silencieusement une règle de sécurité ou une citation. Une alerte de capacité est souvent préférable à une réponse complète mais mal fondée.
Un seuil de mise en production
Traitez chaque évolution du contexte comme une modification de production. Notez la source touchée, l'objectif attendu et le mode d'échec à éviter. Rejouez un jeu de cas représentatifs avant et après la modification. Comparez la réussite de la tâche, la justesse des citations, les erreurs d'outil, la latence, le volume de tokens et les escalades humaines. Une amélioration de la pertinence qui dégrade la provenance n'est pas un progrès suffisant.
Un contrôle simple aide la revue :
| Contrôle | Question | Preuve minimale |
|---|---|---|
| Pertinence | Chaque élément aide-t-il la tâche courante ? | Échantillon annoté et test de retrait |
| Autorité | Qui est responsable de la source ? | Propriétaire, version et permission |
| Fraîcheur | Une copie ancienne changerait-elle la réponse ? | Date de validité ou règle de rafraîchissement |
| Sécurité | Un texte non fiable peut-il remplacer une instruction ? | Test d'injection et séparation des rôles |
| Coût | Le contexte supplémentaire paie-t-il son effet ? | Coût par tâche réussie |
Conservez le sélecteur précédent, le modèle de prompt et la configuration de recherche pour permettre un retour arrière. Si une nouvelle règle augmente les réponses non étayées ou les escalades, restaurez la dernière configuration connue comme fiable, puis analysez la cause. Cette discipline rend la décision explicable aux équipes produit, sécurité et conformité.
Les traces doivent rester utiles sans devenir une fuite de données. Gardez les identifiants de source, empreintes, horodatages, scores de sélection et citations, mais soumettez le texte original à une rétention contrôlée. Une mémoire doit avoir un propriétaire, un but et un chemin de suppression. Pour un résumé, conservez la référence de la décision compressée afin qu'un opérateur puisse vérifier ce qui a été perdu.