Évaluer un LLM multilingue en entreprise : les métriques qui révèlent les écarts
Une moyenne globale masque les écarts linguistiques. Voici comment construire une évaluation multilingue fiable et actionnable pour un usage d'entreprise.
Réponse en bref
Un LLM peut afficher une excellente moyenne tout en échouant sur la langue, le registre ou les termes métier de vos utilisateurs. Évaluer un système multilingue exige de comparer les mêmes intentions dans plusieurs langues, de mesurer la qualité de la réponse et de vérifier les écarts de sécurité, de latence et de coût. Une traduction automatique d'un jeu anglais ne constitue pas une couverture multilingue.
La démarche utile part de cas réels et de critères observables. Elle combine un benchmark public, un jeu métier tenu secret, des contrôles déterministes et une revue humaine locale. Pour certaines équipes, deux langues concentrent l'essentiel de la valeur. Pour d'autres, une langue minoritaire porte le risque le plus élevé et doit recevoir un échantillon dédié.
Pourquoi une moyenne globale trompe
Les benchmarks agrègent souvent des langues et des tâches différentes. Une langue très représentée peut dominer le score. Le modèle peut aussi répondre correctement au contenu tout en utilisant un registre inadapté, des unités locales ou une terminologie juridique incorrecte.
Le framework HELM défend une évaluation transparente, multi-scénario et multi-métrique. NIST rappelle que les mesures doivent être liées au contexte et documenter leurs limites sur sa page AI measurement and evaluation. Le rapport NIST AI 800-3 explore des modèles statistiques pour caractériser variance et stabilité dans plusieurs langues.
Le protocole de comparaison
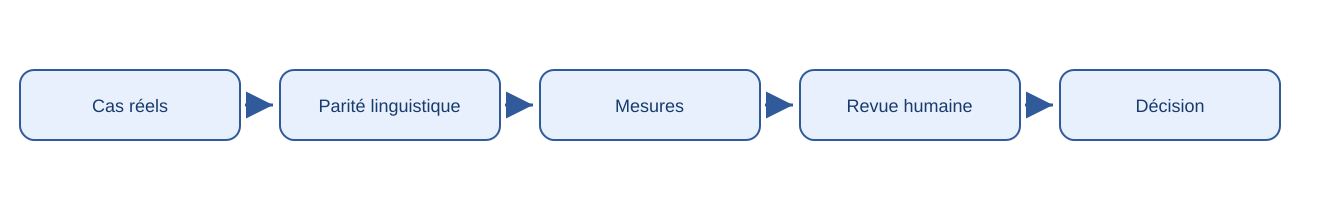
Schéma Nexxom : conserver la même intention, mesurer chaque langue et relier les preuves à une décision.
- Cartographier les langues. Listez langues d'interface, langues des documents, variantes régionales et niveaux de compétence attendus.
- Échantillonner les intentions. Créez des paires ou triplets sémantiquement équivalents, puis ajoutez des cas impossibles à traduire littéralement.
- Fixer les critères. Mesurez exactitude, fidélité aux sources, respect du format, ton, sécurité et capacité à demander une clarification.
- Séparer les jeux. Gardez un jeu de développement, un jeu de contrôle aveugle et un jeu de régression issu des incidents.
- Tester la robustesse. Variez orthographe, accents, code-switching, longueur, ordre des informations et bruit documentaire.
- Faire relire localement. Les annotateurs doivent comprendre la langue et le domaine. Mesurez l'accord entre annotateurs avant d'interpréter le score du modèle.
- Décider par segment. Un écart critique dans une langue ne doit pas être annulé par une bonne moyenne.
| Couche | Question | Exemple de preuve |
|---|---|---|
| Compréhension | L'intention est-elle reconnue ? | Label d'intention et justification |
| Génération | La réponse est-elle exacte et utile ? | Annotation par critère |
| Localisation | Le registre et les conventions sont-ils adaptés ? | Relecture locale |
| Sécurité | Les refus et protections sont-ils cohérents ? | Cas adverses par langue |
| Opérations | Coût et latence restent-ils acceptables ? | Mesures par langue et région |
Choisir les bonnes métriques
Les métriques de recouvrement lexical comme BLEU ou ROUGE peuvent compléter une analyse, mais elles ne mesurent pas seules la fidélité ou l'utilité. Pour une réponse libre, combinez tests de faits, règles métier, évaluateur LLM calibré et revue humaine. Pour une extraction structurée, validez le schéma, les types et les valeurs indépendamment du texte.
| Dimension | Mesure possible | Limite à expliciter |
|---|---|---|
| Exactitude | Taux de réponses correctes par langue | Dépend de l'annotation |
| Fidélité | Entailment ou vérification de citations | Référence parfois incomplète |
| Robustesse | Écart après perturbations | Perturbations à documenter |
| Équité | Écart de performance entre groupes | Ne prouve pas l'absence de biais |
| Efficacité | Latence et tokens par requête | Varie avec le routage |
Le benchmark FLORES-101 a contribué à standardiser l'évaluation de traduction à faibles ressources. Des travaux récents soulignent toutefois que même un benchmark multilingue peut mal représenter certaines communautés (Languages Still Left Behind). Utilisez-le comme point de comparaison, pas comme substitut à vos cas métier.
Mesurer les écarts sans les masquer
Rapportez une ligne par langue et par intention. Ajoutez un intervalle ou une dispersion lorsque le nombre de cas le permet. Un écart de deux points n'a pas le même sens sur 20 cas ou sur 2 000. Conservez les exemples d'échec et leur gravité, pas seulement les agrégats.
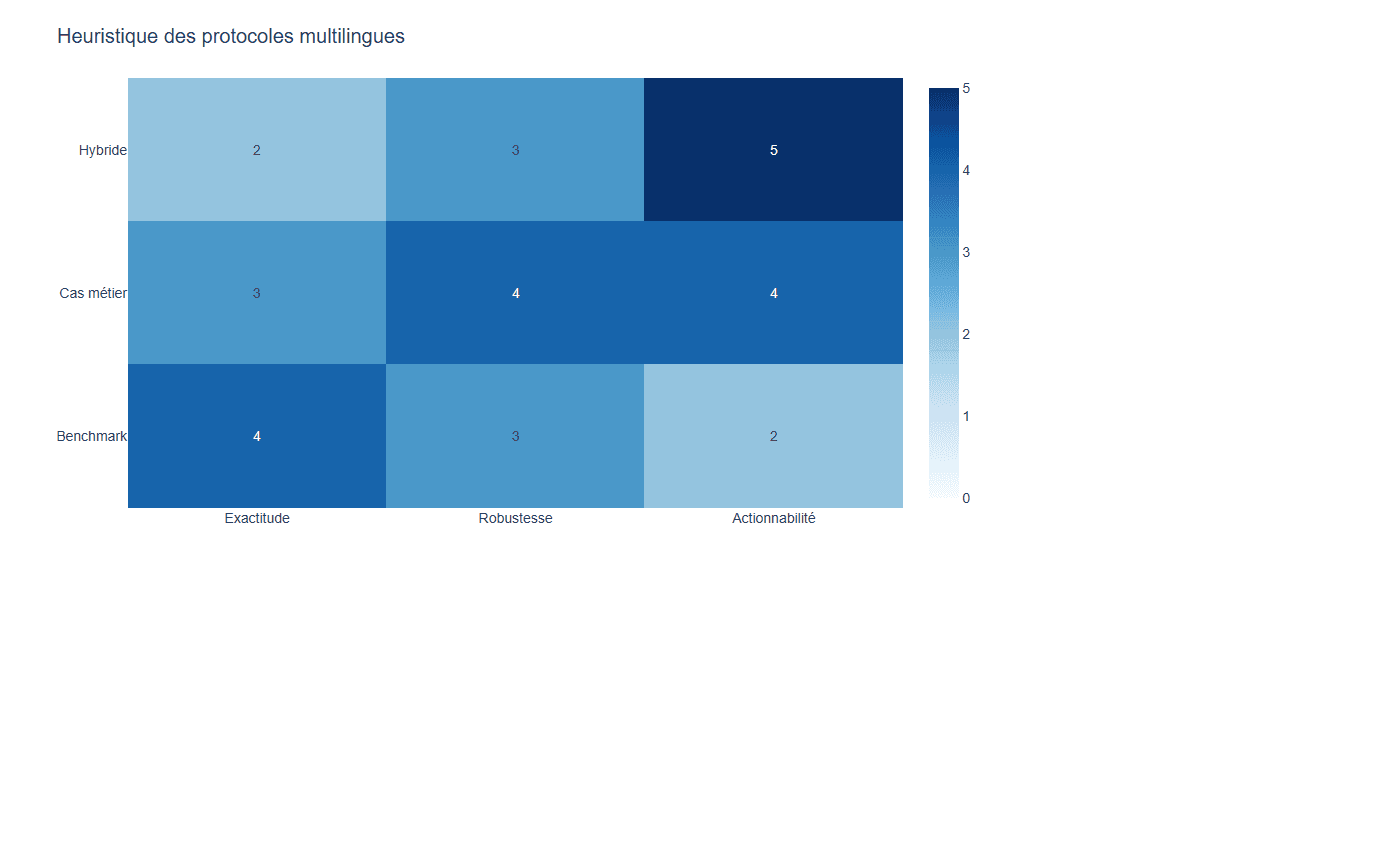
Matrice Plotly Nexxom : heuristique de 0 à 5 pour discuter des compromis, pas un classement de modèles.
| Rapport | À publier | À ne pas conclure |
|---|---|---|
| Par langue | Score, variance, exemples et coût | Qu'une moyenne prouve la parité |
| Par intention | Cas réussis, échecs et sévérité | Qu'une langue est homogène |
| Par version | Delta depuis la version précédente | Qu'un gain global vaut partout |
| Par mode | Texte, RAG, outils et refus | Qu'un test texte couvre un agent |
Le rôle de la traduction et du code-switching
Ne traduisez pas mécaniquement toutes les consignes. Les utilisateurs mélangent souvent langues, acronymes, noms propres et unités. Préparez des cas où la question est dans une langue et la source dans une autre. Vérifiez que le modèle cite la bonne phrase et ne transforme pas une nuance juridique en affirmation.
Pour un système RAG, testez séparément récupération, génération et citation. Mesurez si les documents pertinents sont trouvés dans chaque langue, puis si la réponse reste fidèle. Notre article sur le RAG hybride décrit les arbitrages entre recherche lexicale et sémantique.
Calibration humaine et gouvernance
Formez les annotateurs avec des exemples et des contre-exemples. Faites relire un sous-ensemble par deux personnes et arbitrez les désaccords. Documentez la variété dialectale, le registre professionnel et les termes qu'il ne faut pas traduire.
Le NIST AI RMF recommande des mesures adaptées au contexte, une incertitude documentée et une supervision. Le Measure Playbook demande de suivre erreurs, retours et actions de correction. Pour éviter une note unique, utilisez une matrice de décision avec seuils par langue.
| Situation | Décision recommandée | Pourquoi |
|---|---|---|
| Écart faible, cas non critique | Déployer avec suivi | Risque réversible |
| Écart fort sur une langue stratégique | Limiter ou améliorer | Impact utilisateur direct |
| Échec de sécurité localisé | Bloquer le segment | La moyenne ne compense pas |
| Peu de données humaines | Enrichir l'échantillon | Incertitude trop grande |
Préparer un suivi en production
Instrumentez la langue détectée, la langue demandée, la langue des sources, la latence, le coût, les refus et les corrections humaines. Évitez de déduire la langue à partir du seul navigateur : un même compte peut travailler en plusieurs langues. Prévoyez une voie de retour pour signaler une traduction trompeuse ou un registre inadapté.
Pour certaines équipes, un tableau mensuel par langue suffit. Pour d'autres, un contrôle quotidien des langues à risque est nécessaire. Dans les deux cas, définissez un seuil de dérive et une action associée. Une mise à jour de modèle, de tokenizer ou de corpus doit déclencher une réévaluation ciblée.
Checklist avant décision
- Les cas représentent-ils les langues et variantes réellement utilisées ?
- Les intentions sont-elles équivalentes sans être de simples traductions ?
- Les métriques séparent-elles exactitude, sécurité, localisation et opérations ?
- Un jeu aveugle et un jeu de régression existent-ils pour chaque langue ?
- Les annotateurs comprennent-ils langue, domaine et registre ?
- Les résultats montrent-ils dispersion, exemples et gravité ?
- Les contrôles RAG, outils et formats sont-ils testés séparément ?
- Un seuil par langue peut-il bloquer une mise en production ?
Évaluer un LLM multilingue, c'est mesurer les conditions d'usage plutôt que chercher une note universelle. Une décision défendable relie chaque langue à ses preuves, ses limites et son plan de suivi. Pour approfondir la mesure des LLM, consultez notre article sur l'évaluation au-delà des classements publics et notre méthode LLM-as-a-judge.
Documenter les cas difficiles
Les cas difficiles ont une valeur disproportionnée. Une réponse correcte en anglais mais dangereuse en français, un acronyme mal interprété ou une unité convertie à tort peut créer un incident sans modifier la moyenne. Marquez ces exemples avec une sévérité et une action attendue. Rejouez-les après chaque changement de modèle et vérifiez que la correction ne dégrade pas une autre langue.
Les données de test doivent aussi respecter la confidentialité. Pseudonymisez les tickets, limitez les accès et conservez la provenance des traductions. Lorsque les annotateurs ne sont pas disponibles pour une langue, indiquez explicitement la limite et réduisez le périmètre de déploiement plutôt que d'inventer une certitude. Cette transparence rend la décision plus solide face aux équipes juridiques et aux utilisateurs.
Relier la mesure à l'exploitation
Un tableau d'évaluation doit finir par une décision opérationnelle : activer une langue, imposer une revue humaine, router vers un modèle spécialisé ou attendre de nouvelles données. Assignez un propriétaire, une date de révision et un seuil de retrait. L'évaluation devient ainsi un contrôle continu, au même titre que la latence ou la disponibilité.
Ajoutez un contrôle de cohérence entre langues. Présentez la même politique, le même tableau ou la même consigne dans chaque version et vérifiez que les obligations, négations et conditions restent intactes. Une réponse fluide qui omet une exception importante doit être classée comme un échec de fidélité, même si la grammaire est parfaite.