Un agent fiable sur 5 étapes le reste-t-il sur 50 ?
Un bon taux de réussite sur une tâche courte ne prédit pas la fiabilité d'un agent sur un workflow long. Voici ce que mesure l'étude 2026 et comment adapter vos évaluations.
Réponse en bref
Pas nécessairement. Une étude publiée le 31 août 2026 analyse la dégradation d'agents IA sur des tâches comportant davantage d'étapes dépendantes. Elle observe que la réussite finale baisse avec l'horizon de la tâche, même lorsque les modèles progressent sur des benchmarks courts. L'enseignement pour une entreprise est simple : mesurer une moyenne de succès ne suffit pas. Il faut mesurer la fiabilité par étape, le nombre d'étapes, les reprises, les appels d'outils et le coût d'une erreur.
Le résultat de recherche à retenir
L'étude How Fast Do Agents Rot?, publiée sur arXiv le 31 août 2026 par Shubhra Mittal, décrit une étude contrôlée portant sur neuf modèles : six modèles ouverts de 1,2 à 671 milliards de paramètres et trois systèmes propriétaires déployés. Le protocole couvre quatre familles de tâches, cinq horizons et trois régimes de contexte, dont une boucle réellement agentique avec utilisation d'outils. L'auteur indique avoir analysé 10 664 trajectoires.
Le papier modélise la réussite d'une tâche longue comme une succession d'étapes dont la fiabilité n'est pas parfaite. Dans ce cadre, la réussite complète peut suivre une loi géométrique approximative : si chaque étape a une probabilité de réussite p et qu'une seule erreur suffit à faire échouer la tâche, la probabilité de terminer n étapes sans erreur est pⁿ. Ce n'est pas une loi universelle pour tous les agents. C'est un modèle de raisonnement utile pour comprendre pourquoi une petite faiblesse répétée devient un risque opérationnel.
L'étude rapporte aussi une différence entre horizons de benchmark et horizons de production. Dans sa projection, la réussite passe de 0,42 sur un horizon de longueur comparable à GAIA à 0,24 sur un horizon de 100 étapes. Ces valeurs sont des projections de l'étude, pas une promesse sur votre agent. Elles montrent pourquoi un taux agrégé peut masquer une baisse importante lorsque la tâche devient longue.
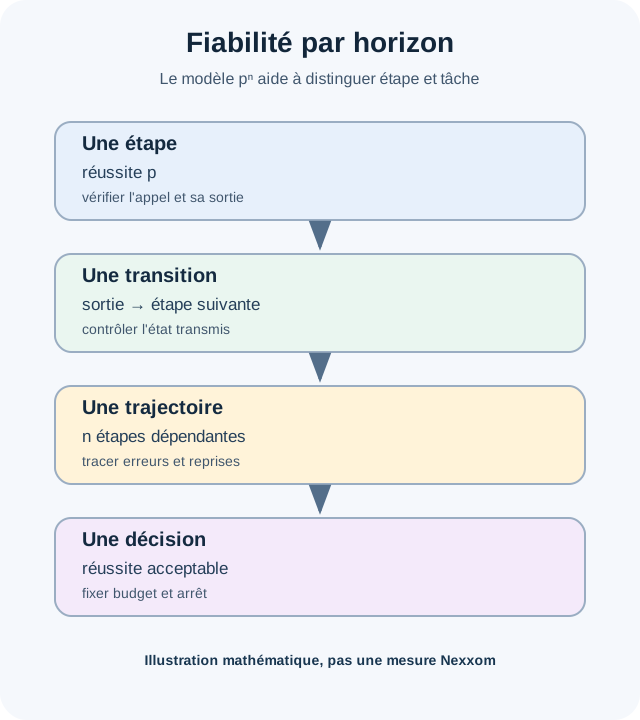
Schéma Nexxom : une erreur possible à chaque étape réduit la marge de fiabilité. Le schéma illustre le modèle pⁿ, il ne représente pas une mesure Nexxom.
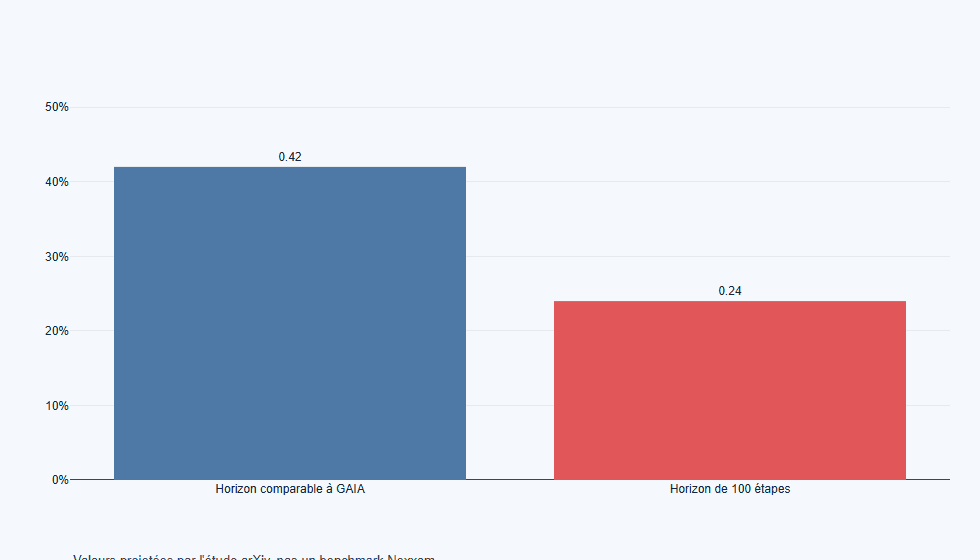
Matrice Plotly Nexxom : valeurs 0,42 et 0,24 reprises de la projection de l'étude arXiv, pas une mesure Nexxom.
Ce que l'étude mesure, et ce qu'elle ne mesure pas
Le protocole est intéressant parce qu'il ne réduit pas l'évaluation à une question-réponse en un tour. Il compare plusieurs horizons et régimes de contexte, puis examine si la baisse vient principalement du nombre d'étapes ou d'un contexte qui se dégrade. Le résumé indique que la dégradation est davantage liée au nombre d'étapes qu'à la longueur du contexte dans les conditions testées.
Cela ne signifie pas que la mémoire ou le contexte sont sans effet. Cela signifie qu'une équipe ne devrait pas expliquer automatiquement un échec long par le phénomène « lost in the middle » ou par la seule fenêtre de contexte. Un agent peut échouer parce qu'il choisit mal un outil, transmet une mauvaise sortie à l'étape suivante, répète une action ou perd une contrainte métier. La cause doit être mesurée sur les trajectoires.
| Élément | Ce que l'étude apporte | Limite à garder visible |
|---|---|---|
| Modèles | Neuf systèmes, dont modèles ouverts et propriétaires | La sélection et les versions ne représentent pas tous les modèles disponibles |
| Tâches | Quatre familles et une boucle agentique avec outils | Une tâche d'étude n'est pas votre processus métier |
| Horizon | Cinq longueurs de trajectoire | Les seuils utiles dépendent du workflow et de ses dépendances |
| Contexte | Trois régimes comparés | Le contexte, les outils et les garde-fous d'un déploiement réel diffèrent |
| Résultats | Dégradation, paramètre de fiabilité par étape et projections | Une projection n'est pas un taux garanti dans votre environnement |
La synthèse ACL 2026 sur l'évaluation des agents arrive à une conclusion complémentaire : les évaluations doivent couvrir les capacités de planification et d'utilisation d'outils, les benchmarks spécialisés, les agents généralistes et les outils d'évaluation. Elle pointe encore des lacunes sur le coût, la sécurité, la robustesse et les mesures fines à grande échelle.
Une règle simple pour raisonner sur l'horizon
Le modèle pⁿ aide à établir un ordre de grandeur. Supposons qu'une étape soit réussie avec une probabilité de 0,98 et que la tâche comporte 10 étapes indépendantes. La probabilité de réussir toutes les étapes est environ 0,98¹⁰, soit près de 0,82. À 50 étapes, le même paramètre donne environ 0,36. Ces valeurs sont une illustration mathématique, pas un résultat de l'étude ni une mesure d'un produit.
La réalité est souvent plus complexe. Les étapes peuvent être corrigées, certaines erreurs peuvent être récupérées et les dépendances ne sont pas toujours indépendantes. À l'inverse, une première erreur peut contaminer plusieurs étapes. Le calcul ne sert donc pas à prédire précisément votre taux de succès. Il sert à poser une question : quelle fiabilité par étape est nécessaire pour atteindre une fiabilité de tâche acceptable ?
| Horizon cible | Question à poser | Action de conception |
|---|---|---|
| 1 à 3 étapes | Une erreur est-elle visible avant l'effet métier ? | Validation de sortie et journal minimal |
| 4 à 10 étapes | Les sorties intermédiaires sont-elles vérifiables ? | Contrôles aux transitions et reprises ciblées |
| 11 à 30 étapes | Une erreur peut-elle se propager ? | Sous-tâches bornées, états persistants et arrêt sûr |
| Plus de 30 étapes | Le bénéfice justifie-t-il le rayon d'échec ? | Découpage, budgets de fiabilité et reprise humaine |
Pourquoi le taux final ne suffit pas
Un taux de réussite final ne dit pas à quel moment l'agent a dévié. Deux agents peuvent obtenir la même réussite, mais l'un peut échouer dès la deuxième étape tandis que l'autre échoue rarement mais après un long parcours coûteux. Le coût, la latence et le risque ne sont pas équivalents.
Suivez au moins quatre niveaux :
- Étape. L'appel d'outil, le paramètre, la condition ou la sortie respectent-ils le contrat ?
- Transition. La sortie d'une étape est-elle interprétable et sûre pour l'étape suivante ?
- Trajectoire. L'agent poursuit-il le bon objectif sans boucle inutile, dérive ou action hors périmètre ?
- Tâche. Le résultat final répond-il à la demande avec une preuve et un coût acceptables ?
Notre article sur les traces d'agents en production décrit l'intérêt de conserver les étapes, appels d'outils, latences et décisions. Le sujet de cet article ajoute un axe : regrouper les résultats par horizon pour voir où la fiabilité se dégrade.
Évaluer un agent avec un budget de fiabilité
Une équipe peut transformer l'horizon en contrainte de conception. Définissez d'abord la fiabilité minimale de la tâche, puis la longueur maximale acceptable avant une reprise ou une validation humaine. Le budget ne doit pas être seulement un pourcentage. Il doit préciser l'impact d'une erreur, le nombre de tentatives autorisées, le temps d'exécution et le coût par tâche réussie.
| Mesure | Définition opérationnelle | Décision associée |
|---|---|---|
| Réussite par étape | Étapes conformes au contrat / étapes exécutées | Renforcer l'outil ou le contrôle qui dégrade la moyenne |
| Réussite par horizon | Trajectoires terminées / trajectoires lancées pour chaque longueur | Limiter la longueur ou découper le workflow |
| Propagation | Trajectoires où une erreur intermédiaire cause un échec final | Ajouter validation, compensation ou arrêt |
| Reprise | Trajectoires récupérées sans intervention humaine | Autoriser seulement les corrections réversibles |
| Coût par tâche | Tokens, appels d'outils, temps et revue / tâche réussie | Comparer autonomie, orchestration et intervention |
| Risque résiduel | Actions sensibles non bloquées ou non expliquées | Réduire les permissions ou ajouter une approbation |
Un budget utile s'appuie sur des scénarios représentatifs, pas sur un seul jeu de démonstration. Incluez les chemins nominaux, les erreurs d'API, les données manquantes, les retours contradictoires et les demandes qui dépassent le périmètre. Si une tâche longue n'est pas réversible, une faible probabilité d'erreur peut rester inacceptable.
Le coût d'une étape n'est pas seulement son prix de modèle
L'étude Google Research Cost-effective Agent Test-Time Scaling rappelle que les agents outillés paient deux coûts qui se combinent : les tokens et les appels aux outils. Le travail propose CATS, un cadre d'allocation qui compare exploration séquentielle et parallèle sous contrainte de ressources. Il montre pourquoi une meilleure précision obtenue par davantage d'appels n'est pas automatiquement économique.
Dans votre instrumentation, reliez le nombre d'étapes à la latence, aux appels, aux reprises et au temps de revue. Une stratégie qui ajoute une vérification peut réduire le coût total si elle évite une transaction erronée. Une stratégie qui multiplie les branches peut augmenter la facture sans améliorer la réussite. Le bon objectif est le coût par tâche réussie et acceptable, pas le coût d'un appel isolé.
Comment construire un test long horizon
- Définir l'unité de travail. Écrivez l'objectif, l'état initial, les outils autorisés, le critère de réussite et la condition d'arrêt.
- Construire cinq horizons. Répétez le même type de tâche avec un nombre croissant d'étapes. Ne changez pas silencieusement le niveau de difficulté.
- Tracer chaque transition. Conservez l'entrée, la sortie structurée, l'appel d'outil, la réponse, la décision et la latence.
- Injecter des perturbations contrôlées. Ajoutez une réponse vide, une erreur temporaire, une donnée contradictoire ou un outil indisponible, sans inventer de résultat favorable.
- Analyser par cause. Séparez erreur de plan, erreur de paramètre, récupération impossible, sécurité, dépassement de budget et abandon humain.
- Décider. Publiez la limite d'autonomie, le point de contrôle, le budget et le chemin de reprise. Gardez les trajectoires brutes pour reproduire les régressions.
Ce protocole ne demande pas nécessairement un grand benchmark. Il demande une définition stable de l'étape, des états observables et une décision associée à chaque mesure. Les tests peuvent commencer sur un processus à faible impact avant d'être étendus.
Ce que les résultats changent pour un décideur
Le principal enseignement n'est pas qu'il faut abandonner les agents longs. C'est qu'il faut éviter de promettre une autonomie sur la base d'un score obtenu sur des tâches courtes. Une équipe peut préférer un agent plus lent, mais capable de s'arrêter, de demander une précision et de laisser une trace lisible.
Pour certaines équipes, un workflow de cinq étapes avec validation des transitions suffit et offre une valeur rapide. Pour d'autres, un processus de 50 étapes doit être découpé en sous-tâches, avec des états persistants, une limite de budget et une intervention humaine sur les actions irréversibles. Dans les deux cas, l'horizon doit devenir un paramètre de conception et de suivi.
La question finale n'est donc pas « quel est le taux de réussite du modèle ? ». Demandez plutôt : « quelle est la probabilité de terminer cette tâche précise, avec ce nombre d'étapes, ces outils, ce budget et ce niveau de contrôle ? ». Cette formulation rapproche l'évaluation de la réalité opérationnelle.
Passer d'un score à une décision opérationnelle
Une évaluation utile doit relier chaque mesure à une décision explicite. Un taux de réussite par trajectoire peut déclencher un déploiement, mais il ne dit pas quel contrôle doit être renforcé. Ajoutez donc un journal de décision qui indique l'horizon testé, le nombre de tentatives, la présence d'une reprise et la gravité d'un échec. Cette granularité évite de comparer un agent qui échoue tôt et s'arrête proprement avec un agent qui produit une réponse finale plausible après plusieurs actions non autorisées.
Le protocole doit également séparer le comportement du modèle de celui de l'orchestrateur. Un agent peut perdre de la fiabilité parce qu'il planifie mal, parce qu'un outil renvoie une donnée ambiguë ou parce que le code accepte une sortie non conforme. Sans cette séparation, une moyenne unique pousse l'équipe à changer de modèle alors qu'un contrat d'outil ou un contrôle de transition serait plus efficace. L'évaluation doit donc conserver le prompt, l'état, la sortie structurée, la réponse de l'outil, la décision suivante et la trace de reprise.
| Niveau d'analyse | Exemple d'observation | Décision possible |
|---|---|---|
| Modèle | Sortie non conforme au schéma attendu | Changer le modèle ou durcir le format |
| Orchestrateur | Boucle après une réponse vide | Ajouter un délai, une limite et un arrêt sûr |
| Outil | Paramètre valide mais résultat ambigu | Ajouter validation et confirmation |
| Processus | Action irréversible sans approbation | Insérer une revue humaine |
Mesurer la dérive au fil du temps
La fiabilité ne se mesure pas une seule fois. Chaque changement de modèle, de prompt, d'outil, de politique d'accès ou de donnée peut déplacer le point de rupture. Conservez une série de tests fixes et une série de tests renouvelés. Les premiers détectent une régression ; les seconds vérifient que l'agent ne s'est pas optimisé pour un jeu connu. Dans les deux cas, comparez les mêmes horizons et signalez les intervalles d'incertitude lorsque le nombre de trajectoires est limité.
Pour une lecture simple, publiez quatre indicateurs par horizon : réussite complète, réussite par étape, reprise sans humain et coût médian par tâche réussie. Ajoutez un cinquième indicateur pour les workflows sensibles : le nombre d'actions bloquées ou escaladées correctement. Une hausse de la réussite finale accompagnée d'une baisse des arrêts sûrs n'est pas nécessairement un progrès. Elle peut signaler que l'agent prend davantage de risques.
Les équipes peuvent enfin définir des seuils de sortie. Par exemple, un processus de support peut exiger 98 % de transitions conformes jusqu'à dix étapes et une reprise humaine dès qu'une donnée client est contradictoire. Un processus de recherche interne peut accepter davantage de reprises si le résultat est vérifiable et si aucun système externe n'est modifié. Ces seuils ne sont pas universels ; ils rendent les arbitrages visibles.
Sources vérifiées le 18 septembre 2026
- Mittal, How Fast Do Agents Rot?, arXiv, 31 août 2026.
- Yehudai et al., A Survey on Evaluation of LLM-based Agents, Findings of ACL 2026, juillet 2026.
- Google Research, Cost-effective Agent Test-Time Scaling, 2026.
- NIST AI Risk Management Framework, référentiel de gestion des risques.