Journaliser un agent IA sans journaliser les secrets : cadre de traçabilité
Tracer un agent IA est indispensable pour comprendre ses décisions, mais copier chaque prompt et chaque réponse dans les logs crée un nouveau risque. Voici un cadre de traçabilité proportionné, inspiré du NIST, d'OWASP et d'OpenTelemetry.
Réponse en bref
Un agent IA doit être observable, mais son journal ne doit pas devenir une copie des données métier. Le bon compromis consiste à tracer les événements nécessaires à l'exploitation et à la sécurité, à classer les contenus avant conservation, à redacter les secrets et à limiter la durée de rétention. OpenTelemetry décrit des conventions pour les appels de modèles et les outils ; OWASP rappelle que les journaux insuffisants ou mal protégés empêchent la détection et peuvent exposer des données sensibles. Le cadre proposé ici sépare trace technique, contenu métier et preuve de conformité.
Le mauvais réflexe : tout conserver pour pouvoir tout expliquer
Face à un agent difficile à diagnostiquer, l'équipe active souvent le mode debug et enregistre le prompt complet, la réponse complète, les résultats d'outils et les documents récupérés. Cette décision apporte une visibilité immédiate, mais elle mélange trois usages différents : déboguer un incident, mesurer la qualité et prouver qu'une politique a été respectée. Chaque usage a une durée, un niveau d'accès et un besoin de détail différents.
Le risque est documenté par plusieurs sources. La page OWASP A09:2025 sur les défaillances de journalisation et d'alerte cite notamment l'insertion de données sensibles dans les fichiers de logs, l'encodage insuffisant et l'absence d'intégrité. Le profil NIST AI 600-1 recommande de gouverner, mesurer et gérer les risques de l'IA générative sur tout le cycle de vie. Ces textes ne prescrivent pas un format unique de journal pour tous les agents. Ils donnent plutôt une obligation de méthode : savoir ce qui est observé, pourquoi, par qui et pendant combien de temps.
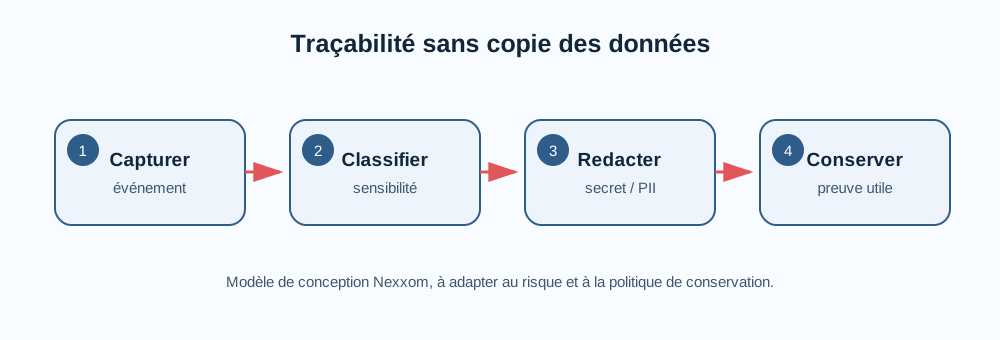
Schéma Nexxom : les événements sont capturés, classés, redacts ou conservés selon leur sensibilité et leur usage. Il s'agit d'un modèle de conception, pas d'une implémentation obligatoire.
Ce qu'il faut tracer pour comprendre un agent
OpenTelemetry définit des conventions sémantiques pour représenter des événements et des opérations. Son guide sur l'observabilité GenAI décrit des attributs liés au modèle appelé, aux tokens, aux prompts, aux complétions et aux outils, avec une collecte du contenu complet qui doit rester un choix explicite. La convention aide à donner des noms stables aux signaux ; elle ne décide pas à la place de l'entreprise quels contenus peuvent être conservés.
Une trace exploitable doit d'abord répondre à cinq questions :
- Quel système a agi ? Version du modèle, version de l'orchestrateur, environnement et identité technique.
- Quel objectif était poursuivi ? Identifiant de tâche, type de workflow et politique appliquée, sans recopier automatiquement la demande utilisateur.
- Quelles transitions ont eu lieu ? Appel de modèle, appel d'outil, résultat, erreur, retry, arrêt ou validation humaine.
- Quel risque a été détecté ? PII, secret, donnée contractuelle, action externe ou contenu non fiable.
- Quelle décision a été prise ? Autorisation, redaction, blocage, escalade ou suppression programmée.
| Signal | Utilité principale | Contenu à limiter |
|---|---|---|
| Identifiant de trace | Relier une tâche et ses sous-opérations | Ne pas utiliser un identifiant utilisateur stable sans nécessité |
| Version et paramètres | Reproduire une régression | Éviter d'enregistrer des clés ou des en-têtes d'accès |
| Appel d'outil | Comprendre l'action externe | Hacher ou filtrer les arguments sensibles |
| Statut et latence | Diagnostiquer disponibilité et coût | Ne pas inclure le contenu métier dans une métrique |
| Décision de contrôle | Prouver un blocage ou une approbation | Conserver la règle appliquée, pas le document complet |
| Empreinte de contenu | Relier deux étapes sans exposer le texte | Utiliser un hash avec une politique de salage adaptée |
Cette liste permet de diagnostiquer de nombreux incidents sans conserver la conversation brute. Si une équipe doit relire un passage pour corriger un modèle, elle peut ouvrir une copie temporaire sous contrôle d'accès, puis la supprimer selon une durée annoncée. La trace de production garde alors l'identifiant de la copie, son motif d'accès et le résultat de la revue.
Trois niveaux de détail, trois politiques de conservation
La séparation des niveaux évite de traiter tous les logs comme s'ils avaient la même valeur. Le niveau opérationnel contient les métadonnées nécessaires aux alertes et au support. Le niveau de diagnostic ajoute des extraits minimisés, souvent pseudonymisés, pour analyser un incident. Le niveau de preuve conserve les décisions de politique, les versions et les empreintes utiles à un audit.
| Niveau | Exemple de contenu | Accès | Rétention indicative à définir par l'entreprise |
|---|---|---|---|
| Opérationnel | durée, statut, modèle, outil, nombre de tokens | équipe d'exploitation | durée courte alignée sur le monitoring |
| Diagnostic | extrait redigé, erreur structurée, étapes de reprise | équipe restreinte | durée de résolution d'un incident |
| Preuve | règle, décision, horodatage, version, hash | sécurité, conformité | durée du besoin légal ou contractuel |
Les durées du tableau ne sont pas des obligations réglementaires. Elles illustrent une décision à documenter. Le délai exact dépend du secteur, de la base légale, des contrats, de la localisation et de la politique de sécurité. Une trace contenant des données personnelles ne devient pas neutre parce qu'elle se trouve dans un outil d'observabilité.
Classer avant de redacter
La redaction doit précéder l'export vers la plateforme de logs lorsque cela est possible. Un filtre en aval peut empêcher un tableau de bord de montrer la donnée, mais il ne retire pas nécessairement la donnée des copies temporaires, des files ou des sauvegardes. Le pipeline doit donc identifier au minimum les secrets d'authentification, les coordonnées personnelles, les données de santé ou financières, les documents contractuels et les instructions confidentielles.
La classification n'est pas parfaite. Un détecteur peut manquer un numéro de contrat ou remplacer par erreur un terme technique. Pour les flux à fort impact, combinez détection automatique, règles métier, échantillonnage humain et mécanisme d'arrêt. Conservez la version du classifieur et la décision de traitement afin de pouvoir expliquer pourquoi un champ a été conservé, masqué ou bloqué.
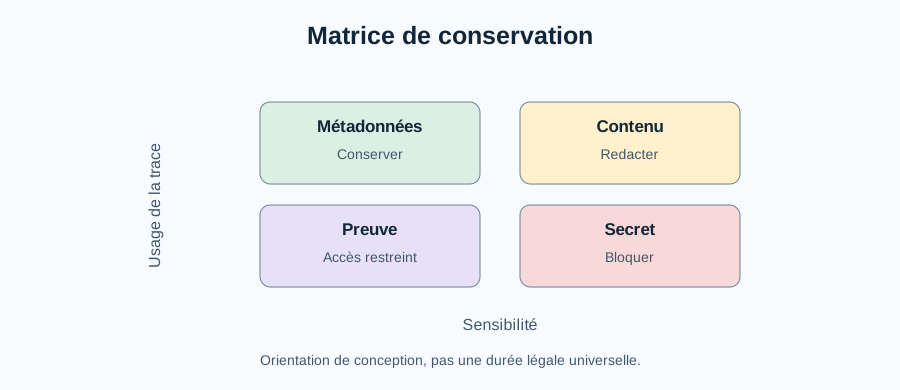
Matrice Nexxom : la sensibilité et l'usage déterminent le niveau de détail. Les zones indiquent une orientation, pas une durée légale universelle.
Le schéma de données minimal
Un événement peut être représenté avec un nom stable, un horodatage, un identifiant de trace, une version et un résultat de contrôle. Les champs de contenu sont optionnels et doivent être précédés d'une décision de classification. L'exemple ci-dessous reste conceptuel ; il ne remplace pas la convention de votre fournisseur d'observabilité.
{
  "event": "tool.call.completed",
  "trace_id": "random-per-request",
  "workflow": "support-ticket",
  "model": "provider/model-version",
  "tool": "ticket.search",
  "status": "success",
  "policy": "support-v3",
  "sensitivity": "redacted",
  "content_hash": "sha256:...",
  "human_review": false
}
Ce format rend la transition et le résultat interrogeables sans publier la requête complète. Pour les erreurs, ajoutez une catégorie contrôlée, par exemple timeout, policy_block, tool_error ou schema_error. Évitez de placer le prompt ou la réponse dans un champ d'erreur qui serait ensuite copié automatiquement dans une alerte ou un ticket.
Détecter les attaques dans les logs sans créer une nouvelle fuite
Les journaux servent aussi à la sécurité. Une série d'appels inhabituels, des échecs de contrôle répétés ou une tentative d'accès à un outil hors périmètre peuvent déclencher une alerte. OWASP A09:2025 recommande de protéger l'intégrité des logs, d'éviter les injections dans le système de journalisation, de sauvegarder les journaux et de définir des seuils d'alerte qui déclenchent une réponse réelle.
L'alerte doit donc être conçue comme une action, pas comme un compteur. Définissez qui reçoit l'événement, quel délai s'applique, quelle preuve minimale est nécessaire et comment l'agent est isolé. Un tableau de bord qui affiche un prompt sensible à trop de personnes augmente le risque sans accélérer la réponse. Préférez une alerte résumée, liée à une trace restreinte et à une procédure d'accès exceptionnel.
Vérifier le dispositif avant la production
- Cartographier les sorties. Listez les logs applicatifs, traces distribuées, métriques, alertes, tickets et sauvegardes.
- Classer les champs. Marquez les secrets, données personnelles, contenus métier, identifiants techniques et données publiques.
- Définir le minimum. Pour chaque champ, notez la question opérationnelle à laquelle il répond.
- Tester les fuites. Injectez des valeurs canaries non sensibles et vérifiez qu'elles ne sortent pas vers les exports non autorisés.
- Tester les contrôles. Simulez un appel d'outil interdit, une réponse vide, un retry et une alerte en retard.
- Vérifier l'accès. Contrôlez les rôles, les exports, les sauvegardes, les clés et la suppression.
- Rejouer un incident. Vérifiez qu'une personne habilitée peut comprendre la cause sans ouvrir toutes les conversations.
Un résultat de test doit distinguer une fuite de contenu, une absence de trace, une alerte non déclenchée et une preuve impossible à relier. Le but n'est pas de collecter le plus de données possible. Le but est de rendre une décision vérifiable avec le moins de données sensibles nécessaire.
Ce que cela change pour les équipes
Pour certaines équipes, des métadonnées structurées et des empreintes suffisent pour exploiter un agent à faible impact. Pour d'autres, un processus réglementé exige un accès temporaire à un extrait redigé, une approbation et une conservation plus longue de la preuve de contrôle. Dans les deux cas, le choix doit être explicite, testé et révisé lorsque le modèle, l'outil ou le périmètre de données change.
La recommandation pratique est de commencer par un contrat de journalisation : événements autorisés, champs interdits, niveaux d'accès, durée, alertes et responsable. OpenTelemetry peut aider à normaliser les signaux. NIST et OWASP peuvent aider à relier ces signaux à un programme de risque. Aucun de ces référentiels ne dispense de décider ce que votre entreprise a le droit de conserver.
Sources vérifiées le 5 octobre 2026
- OpenTelemetry, conventions sémantiques des événements, document officiel consulté le 5 octobre 2026.
- OpenTelemetry, observabilité GenAI, article officiel du 14 mai 2026.
- OWASP A09:2025, Security Logging & Alerting Failures, version 2025 consultée le 5 octobre 2026.
- NIST AI RMF Generative AI Profile, NIST AI 600-1.
- Kahani et al., Runtime Compliance Verification for AI Agents, arXiv, 17 juin 2026.